在刚刚落幕的2026科大讯飞全球1024开发者节主论坛上,端云一体大模型讯飞星火X2.6及系列产品在会上发布。“这一版本首次在全国产算力平台上完成训练,实现代码、智能体、超长上下文任务能力的重大突破,以底层算法与工程创新,消解国产硬件客观短板,推动全栈自主可控大模型走向规模化产业落地。”科大讯飞词元星火CTO刘权如是说。
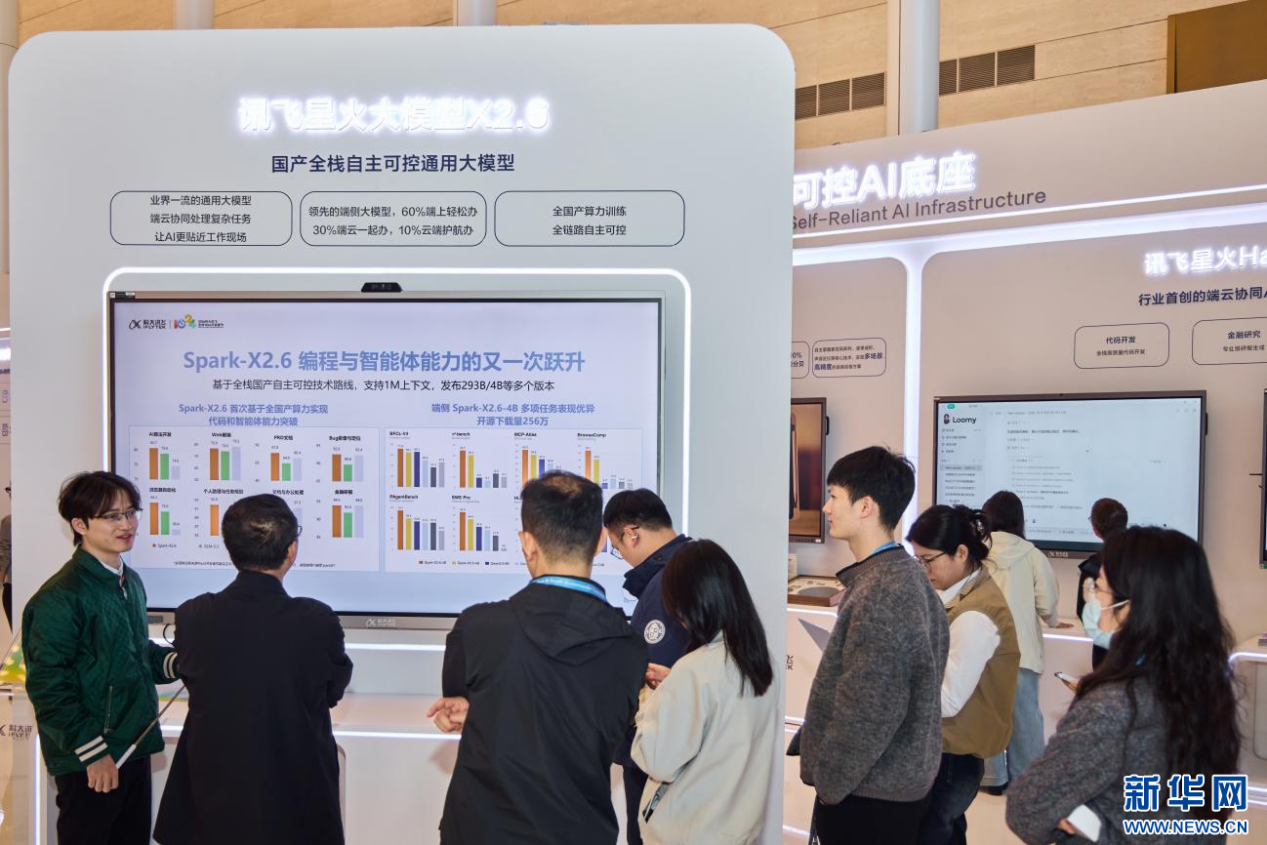
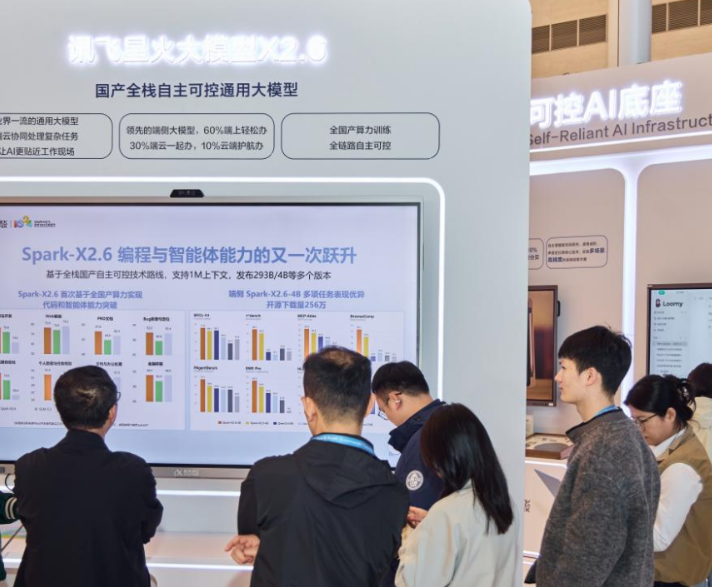
日前,2026科大讯飞全球1024开发者节北京科博展现场,受邀嘉宾在科大讯飞星火X2.6展台前咨询。新华网发(梁家伟 摄)
当前,AI应用快速走向产业落地,代码生成、智能体自主执行、百万Token超长文档处理已经成为企业刚需。但客观现实是,国产芯片在显存、带宽、集群软件生态上仍存在短板,超长上下文、代码、智能体这类高复杂度任务,会带来巨大的显存占用与计算压力,极易出现“放不下、算不快”的行业痛点,万卡规模集群训练的稳定性,更是摆在研发团队面前的现实难题。
“国产算力做大模型训练,最大的挑战不是单点算法,而是整套软硬件生态。”刘权坦言,大模型主流算法、训练框架、底层算子大多需要从零开始构建。尤其万卡级大规模集群训练,小规模训练不易暴露的各类稳定性问题会集中爆发。团队需要从算子优化、通信调度、并行训练策略多维度做深度重构与适配,联合国产算力伙伴补齐底层软件栈能力,才能把国产硬件的算力真正释放出来。
面对硬件条件的客观约束,词元星火团队针对性完成多项原创技术攻坚。在训练环节,创新长程任务动态并行训练技术,可以根据任务文本长度自适应分配计算资源,把超长上下文训练效率提升约4倍;推理侧,落地基于国产算力的自适应存算协同计算方法,落地业界首个面向全国产设备的四层KVCache技术,叠加分布式推理方案,推理效率实现4.5倍提升,让代码、多轮智能体规划、百万级长文档解析等高难度任务得以高效完成。
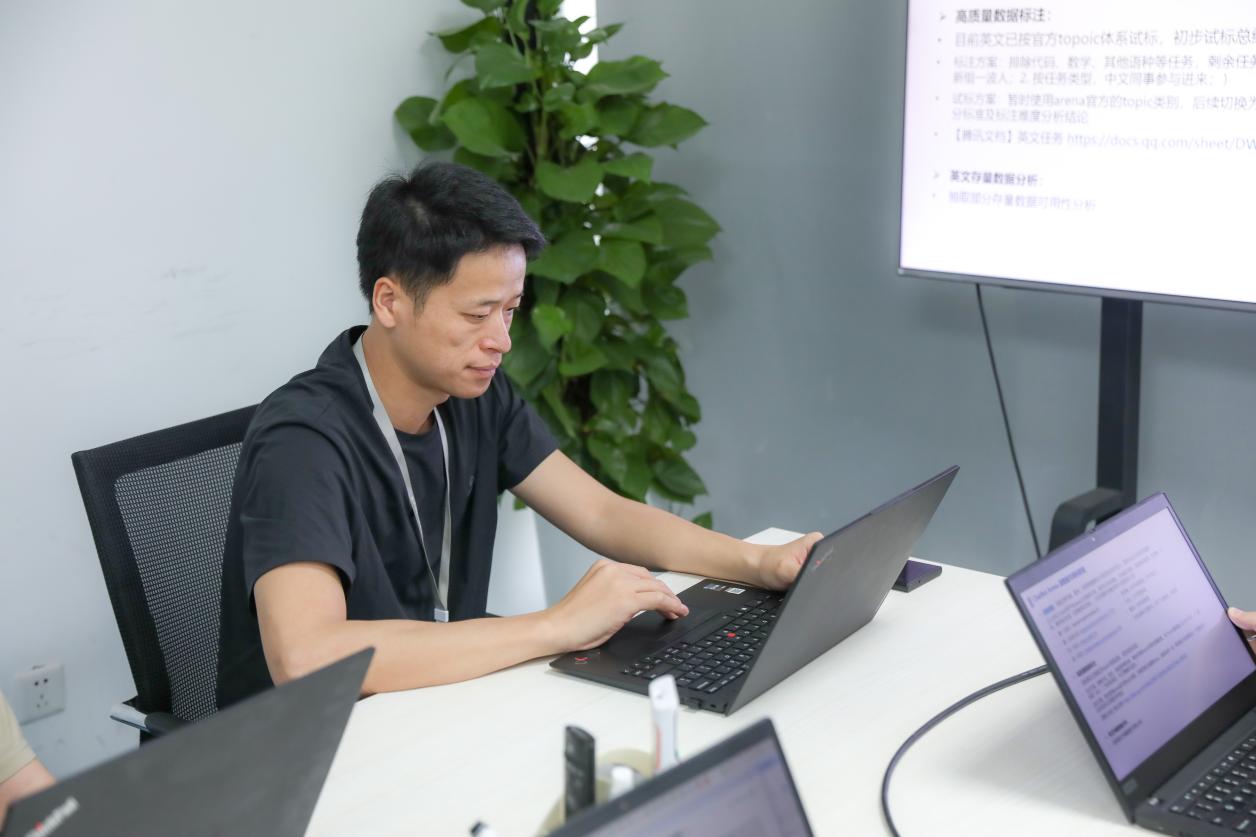
刘权与团队伙伴测试、研讨星火X2.6大模型相关内容。(科大讯飞供图)
“全栈自主可控的关键标准,不仅是模型能在国产芯片做推理,更要完整在国产平台完成训练,产出对标国际一流水平的大模型。”刘权表示,这也是星火X2.6最重要的价值所在——整套旗舰基座的训练全部基于国产算力完成,实现代码、智能体能力的跨越式升级,证明全国产算力链路完全有能力支撑复杂大模型的完整迭代进化。
星火X2.6同时打通云端与端侧能力闭环。端侧版本星火X2.6-4B依托端云一体联合训练,端侧可独立完成的智能体任务覆盖度提升至41.9%,可以本地读取邮件、附件、周报完成经营风险研判,做到业务数据不出设备即可完成分析工作。配套全新端云一体协同架构,通过评语模型驱动的端云路由协同训练,任务路由准确率达到96.1%。端侧自主判断任务难度,复杂任务先做本地敏感信息脱敏,经用户确认后再交由云端运算,结果回传本地还原输出,兼顾隐私安全与复杂问题处理能力,为企业数字化提供安全的AI执行路径。
“技术突破最终要落到真实业务场景。”刘权表示,词元星火建立起一套完整的迭代闭环:大模型新版本完成技术研发后,首先在集团内部开展大规模行业内测,把来自教育、医疗、法律、企业数字化一线的真实业务问题持续反馈回模型研发团队,反向驱动基座迭代优化。
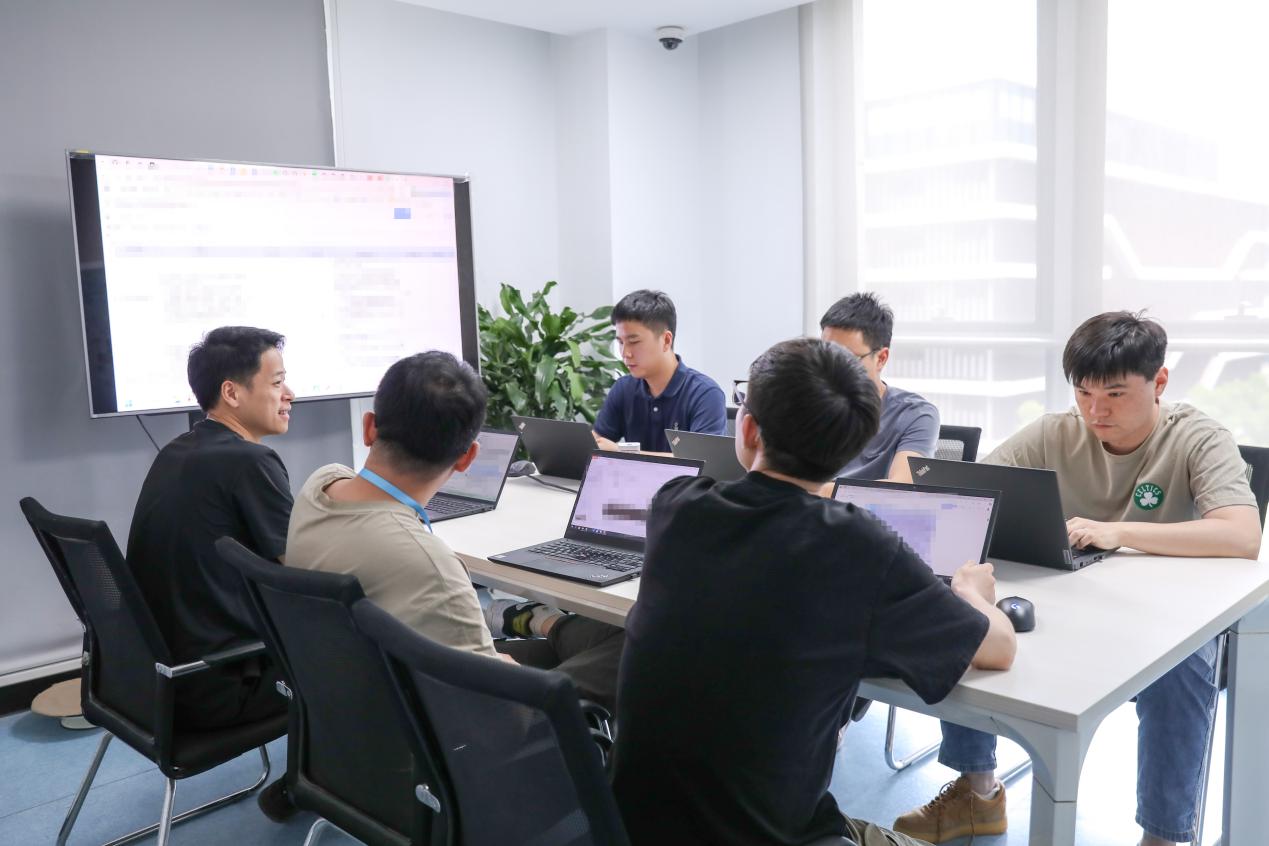
刘权与团队伙伴测试、研讨星火X2.6大模型相关内容。(科大讯飞供图)
如今,依托端云一体星火X2.6打造的超级法律助手,覆盖法律全流程工作,办案效率提升45%以上,面向企业组织的讯飞星帆 WinWork数字员工平台,基于星火X2.6底座,Token消耗节约44%,同时支持全栈国产化私有化部署,运行过程可审计、可追溯。
刘权透露,团队还在研发新一代大模型架构,计划于明年上半年推出。团队将持续联合华为、曙光等国产算力伙伴,持续打磨算子、训练框架与集群调度体系,以算法和工程创新持续消解硬件代差,推动国产算力生态共同成长。未来,将持续开放模型能力,携手广大开发者,让基于全国产算力训练的大模型,赋能更多真实业务场景,为国内人工智能产业构筑自主可控的技术底座。